Фармакон
совместно с evolve team
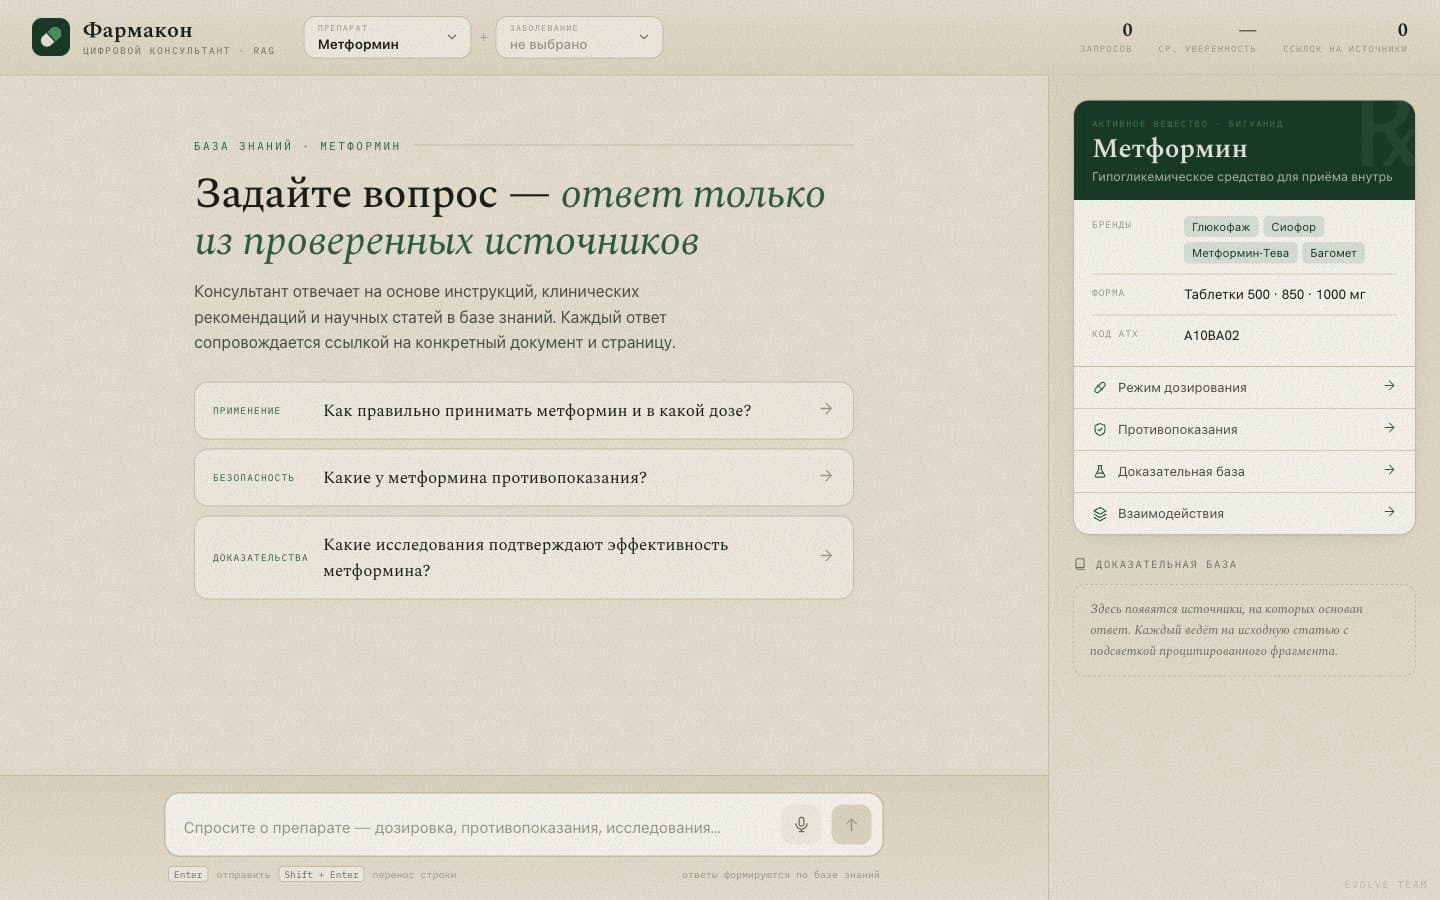
- [01] Задача
- Отвечать на вопросы о препаратах (в базе для примера метформин) только по проверенным источникам, без домыслов.
- [02] Что сделали
- RAG-консультант по базе знаний из инструкций, клинических рекомендаций и научных статей. К каждому ответу прикладывается ссылка на конкретный документ и страницу, рядом показан процитированный фрагмент.
Как это устроено
Фармакон — ИИ-консультант по медицинским препаратам, сделанный для ООО «Ай-Сис Лабс» на кейс-чемпионате «Цифровые решения в медицине» (СамГМУ). Врач задаёт вопрос на естественном языке и получает ответ строго на основе документов, загруженных в базу знаний, — с источником рядом с каждым утверждением.
Сложность медицинского ассистента не в чате, а в том, чтобы он ничего не выдумывал. Весь пайплайн ниже существует ради этого: если источника для ответа нет — система говорит «нет данных», а не угадывает.
Открыть сайт ↗- 01
Вопрос на естественном языке — ответ со ссылками
Врач задаёт реальный вопрос — как принимать препарат, какие противопоказания, какие есть исследования — и получает текст со ссылкой [n] после каждого утверждения. Без простыни поисковой выдачи.
К каждому ответу прилагается доказательная база с реальными цитатами, оценка уверенности и дисклеймер о справочном характере. Цель — инструмент, которому врач может доверять с одного взгляда, а не уверенный в пустоте чат-бот.
Под капотом: Фронтенд React + Vite, бэкенд на FastAPI. Объект ответа — это контракт: текст с маркерами [n], список процитированных фрагментов, оценка уверенности и статус (answered / nodata).
- 02
Как документы становятся базой для поиска
Исходные документы — PDF, DOCX, HTML и даже сканы — читаются постранично, режутся на фрагменты ~800 символов по границам предложений и кодируются в векторы. Сканы сначала проходят OCR, чтобы ничего не потерялось.
Каждый фрагмент хранит метаданные: источник, его тип, URL и якоря начала/конца — по ним цитата подсвечивается прямо на странице-источнике.
Под капотом: Парсинг через pypdf / python-docx / BeautifulSoup, OCR через pytesseract + pdf2image. Фрагменты (~800 символов, перекрытие 120) кодируются моделью multilingual-e5-small и кладутся в ChromaDB на диск со всеми метаданными, включая якоря text fragments.
- 03
База растёт по запросу
Вы не ограничены тем, что загрузили заранее. Введите любой препарат или заболевание — система сама найдёт статью в Википедии, обогатит её инструкцией openFDA и аннотациями PubMed, проиндексирует и добавит новой темой.
База знаний — не фиксированный буклет, а то, что расширяется под реальные вопросы врача.
Под капотом: Запрос инициирует выгрузку из Википедии + openFDA + PubMed, она чанкуется, кодируется и пишется в ChromaDB на лету, с тегом типа источника — чтобы балансировать выдачу при поиске.
- 04
Два поиска, сведённые в один рейтинг
За каждым ответом — два поиска одновременно: смысловой, который понимает суть вопроса, и лексический, который ловит точные термины. Их результаты объединяются, и самые сильные фрагменты всплывают наверх.
Система гарантирует, что лучший фрагмент каждого типа источника попадёт в шорт-лист, чтобы данные FDA и PubMed не вытеснялись более длинными русскоязычными текстами.
Под капотом: Векторный поиск (косинус по эмбеддингам e5) + BM25, объединение через Reciprocal Rank Fusion (c=60). 80 кандидатов на поиск → top-6 в LLM, с гарантией лучшего по каждому типу источника выше порога 0.35.
- 05
Отказывается, а не выдумывает
Если ни один фрагмент базы не дотянул до вопроса — система отвечает «нет данных» и не зовёт модель на пустом контексте. А если модель ответила, не сославшись ни на один источник, такой ответ тоже отклоняется.
В медицине этот отказ и есть фича: честное «у меня нет этих данных» лучше уверенной фразы без основания.
Под капотом: На входе min_score (по умолчанию 0.50) — ниже него статус nodata, и LLM не вызывается. На выходе маркер отказа или ответ без ссылок [n] понижается до nodata. Если LLM недоступна — extractive-режим собирает ответ из лучших фрагментов.
- 06
Каждое утверждение указывает на цитату
Ответ генерируется под жёстким промптом: отвечать только по переданным фрагментам, ничего не добавлять, ставить ссылку [n] после каждого утверждения. В доказательную базу попадают только реально процитированные фрагменты.
У каждого источника есть цитата, оценка релевантности и ссылка — а где источник это позволяет, цитата подсвечивается прямо на оригинальной странице.
Под капотом: Генерация через DeepSeek / OpenAI / Ollama с системным промптом, требующим ссылок. Постобработка оставляет только процитированные фрагменты, перенумеровывает ссылки подряд и прикладывает к каждой цитату с URL источника и якорем text fragment.
- 07
Что на самом деле значит число уверенности
Проценты рядом с ответом — это косинусная близость самого похожего фрагмента базы к вопросу, то есть насколько база совпала с запросом, а не насколько уверена модель.
Считается на этапе поиска, до запуска LLM, и отвечает на вопрос «нашёлся ли реально релевантный текст?». На фронте число красится зелёным / жёлтым / рыжим, но решает, дать ли ответ, только min_score.
Под капотом: confidence = максимальная косинусная близость среди отобранных top-6, округлённая до сотых — от LLM не зависит. Зоны: ≥0.85 высокая, 0.65–0.85 средняя, <0.65 низкая. Эндпоинт /stats сводит за сессию число запросов, долю nodata, среднюю уверенность и оценки обратной связи.